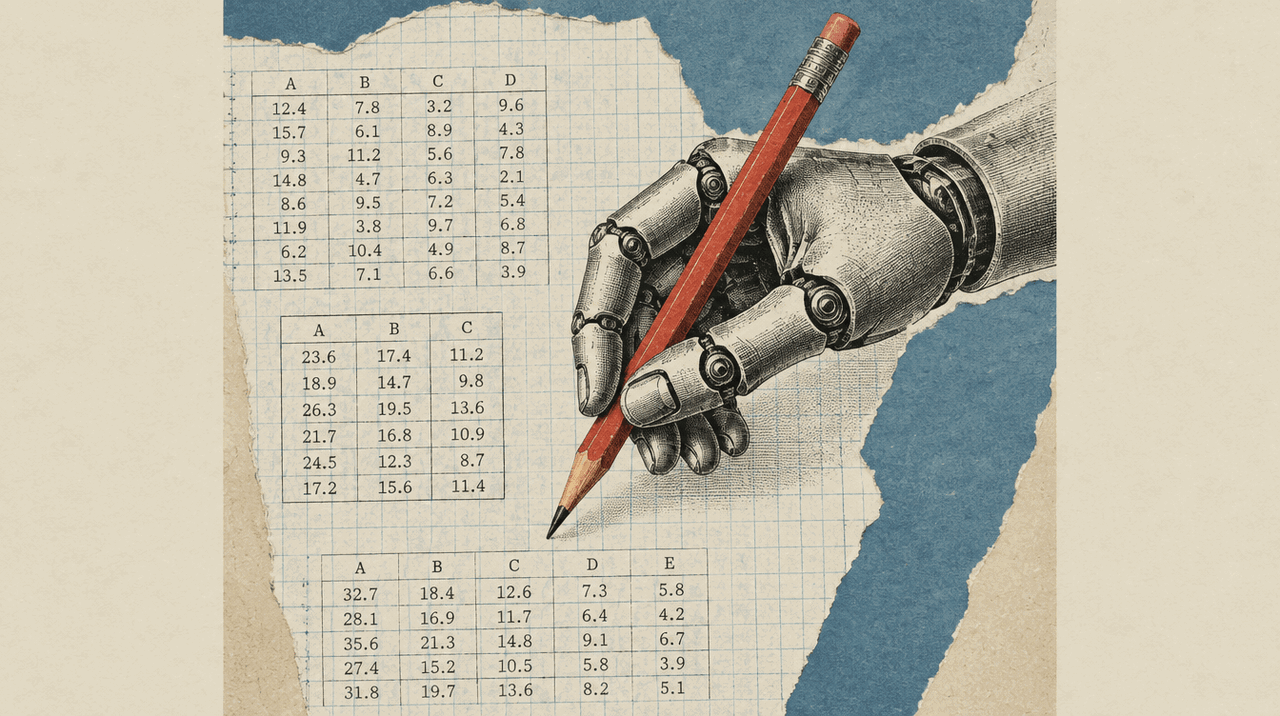Publizieren ohne Text: Frontiers macht Datensätze zu Fachartikeln und eine KI zur Lektorin
...in zwölf Monaten ist allerdings erst eine Handvoll dieser Publikationen erschienen. Woran das liegt, und was jeder Verlag daraus lernen kann, der gerade KI in seine Produktion einbaut.
Published: 24.9.2026 | Keyvisual: KI-generiert, Magnific
Ein Schweizer Wissenschaftsverlag hat ein Produkt auf den Markt gebracht, in dem kein geschriebener Satz steckt. Frontiers, eines der größten Open-Access-Häuser der Welt, verkauft seit 2025 reine Forschungsdaten als vollwertige Veröffentlichung. Eine KI räumt den Datensatz auf und beschreibt ihn, Fachleute begutachten ihn, ein Portal stellt ihn aus. Am Ende steht eine zitierfähige Publikation. Rund 5.500 Schweizer Franken kostet das, obwohl dieselben Daten in offenen Archiven gratis liegen dürfen. Trotzdem ist in zwölf Monaten erst eine Handvoll dieser Publikationen erschienen. Die australische Bibliotheks- und Informationsspezialistin Lilly Hoi Sze Ho hat das System für das Fachmagazin Katina geprüft. Ihr Befund lohnt auch für Verlage außerhalb der Wissenschaft.
In der Wissenschaft gilt dieselbe Rangfolge wie in den meisten Fachverlagen.
Publiziert wird der Text, das Material dahinter ist Beilage. Messreihen, Tabellen und Rohdaten landen kostenlos in offenen Archiven, etwa bei Zenodo, das vom Forschungszentrum CERN betrieben wird, oder bei Figshare. Dort bekommen sie eine dauerhafte Adresse, den DOI, und bleiben liegen. Verdient wird eine Ebene darüber, am Aufsatz.
Frontiers dreht diese Ordnung um, und zwar mit Ansage. „90 % of Science Is Lost“ überschrieb der Verlag die Pressemitteilung zum Start seiner Plattform FAIR², gesprochen „Fair Squared“.
Das Angebot besteht laut Hos Beschreibung aus drei Bausteinen. Eine KI-gestützte Kuratierung überführt Rohdaten in ein maschinenlesbares Paket und reichert die Metadaten an. Ein eigenes Portal pro Datensatz stellt sie aus, mit Visualisierung, Explorationswerkzeugen, herunterladbarem Jupyter-Notebook und einem generierten Podcast. Und ein begutachteter Data Article erscheint in einem Frontiers-Journal und macht den Datensatz zitierfähig.
Der Plattformname spielt auf die FAIR-Prinzipien an, nach denen Forschungsdaten findable, accessible, interoperable und reusable sein sollen, also auffindbar, zugänglich, interoperabel und wiederverwendbar. Das hochgestellte Quadrat suggeriert, das alles zu potenzieren. Praktisch heißt es vor allem eines: Der Datensatz bekommt einen Beipackzettel, den nicht nur Menschen lesen können, sondern auch Maschinen.
- Anzeige -
Die Lektorin heißt Clara, die Leser sind Maschinen
Das Herzstück des Verfahrens ist eine KI, die Frontiers als Data Steward bezeichnet und Clara nennt.
Clara bereinigt und validiert Daten, erzeugt Datenwörterbücher, schlägt Metadatenfelder und Variablenbeschreibungen vor, ordnet die Methodendokumentation und prüft gegen den hauseigenen Standard. Im Portal bleibt ein Chatfenster sichtbar, das Fragen zu Schema und Artikelaufbau beantwortet. Die Metadaten landen im Croissant-Format, einem Standard der MLCommons-Initiative, der Datensätze für das Training und die Auswertung durch KI-Modelle beschreibt.
Damit ist klar, für wen hier publiziert wird. Der Leser eines Data Article ist in erster Linie ein Modell, das Trainingsdaten sucht, oder ein Skript, das über hundert Datensätze hinweg eine Metaanalyse rechnet. Frontiers baut ein Verlagsprodukt für einen maschinellen Leser, und die menschliche Begutachtung beglaubigt, dass die Maschine nichts Falsches vorgesetzt bekommt. Passend dazu müssen Einreichende offenlegen, wo KI-generierte Inhalte in Daten oder Dokumentation eingeflossen sind.
Ho markiert in ihrem Artikel die Grenze der Automatisierung präzise. Wie gut Clara Metadaten erzeugt, hängt an der Qualität der ursprünglichen Dokumentation, an der Kontrolle durch die Forschenden und an Fachwissen, das automatisierte Werkzeuge womöglich nicht abbilden. Die KI beschreibt, was sie vorfindet. Was in einem schlecht dokumentierten Datensatz fehlt, ersetzt sie nicht.
Wofür 5.500 Franken bezahlt werden
Speicherplatz kostet bei Zenodo nichts, bei Frontiers kostet er 5500 Schweizer Franken.
Die Einführungsgebühr, umgerechnet rund 5800 Euro oder 7100 US-Dollar, gilt für Datensätze bis 50 Gigabyte und deckt KI-Kuratierung, Begutachtung, Portal und dauerhaftes Hosting ab. Fällig wird sie erst nach der Annahme.
Dazu kommt die Publikationsgebühr des jeweiligen Journals. Als Ho ihre Rezension im Mai 2026 schrieb, wies Frontiers diese nicht einzeln aus, weshalb sie die Preistransparenz nur teilweise gegeben und die Summe für kleine Teams und Einzelforschende möglicherweise abschreckend nannte.
Seither hat der Verlag seine Gebührenordnung überarbeitet. Sie nennt vier Kategorien zwischen 990 und 3150 Franken, gestaffelt nach Reife des Journals und Finanzkraft des Fachgebiets, weist die Gebühr auf jeder Journalseite aus und beschreibt, was sie abdeckt. Wer nicht zahlen kann, beantragt Nachlass. 2025 hat Frontiers nach eigenen Angaben über neun Millionen Dollar erlassen.
Interessanter als die Höhe der Gebühren ist die Logik dahinter. Verkauft wird die Beglaubigung. Ein DOI vom Repository sagt, dass die Daten existieren. Ein begutachteter Data Article sagt, dass jemand mit Fachwissen hineingesehen hat und dass die Struktur einem veröffentlichten Standard genügt.
Dafür gibt es Zitierfähigkeit, Anerkennung im Wissenschaftsbetrieb und den Nachweis gegenüber Förderern, die Datenmanagementpläne längst vorschreiben. Aus deren Töpfen lässt sich die Gebühr laut Ho auch bezahlen.
Eine Handvoll Artikel in zwölf Monaten
Der erste begutachtete Data Article erschien im März 2025.
Als Ho das System im Februar 2026 prüfte, waren die Pilotdatensätze durch, dazu ein Artikel vom Dezember und zwei vom Januar, thematisch von Coronavirus-Varianten bis zu Biodiversitätserhebungen im Indopazifik. Eine Handvoll, nach einem Jahr Betrieb. Ho vermutet daher, dass Begutachtung und Zertifizierung nur langsam vorankommen.
Offenbar sitzt der Engpass genau dort, wo KI nicht hilft. KI beschleunigt das Aufbereiten, das Gutachterverfahren organisiert Frontiers aber wie bei seinen Textjournalen. Ein Datensatz aus der Meeresforschung braucht andere Fachleute und andere Metadatenstandards als einer aus der Wirkstoffforschung. Ob sich fachspezifische Betreuung mit einer einheitlichen technischen Architektur verbinden lässt, bleibt laut Ho offen. Genau diese Unterschiede haben schon frühere FAIR-Infrastrukturen ausgebremst.
Ihre weiteren Beobachtungen lesen sich wie ein Abnahmeprotokoll, das jeder Verlag kennt, der eine Plattform ausgerollt hat.
Barrierefreiheit: Das Portal bietet weder Übersetzung noch Vorlesefunktion.
Schnittstelle: Die API liefert Metadaten und Download-Links, gefilterte Abfragen kaum.
Dokumentation: Die Anleitung für die Data Articles bleibt dünn.
Anmeldung: Der ORCID-Login quittierte mehrere Versuche mit einer nackten Fehlernummer, der Umweg lief über eine E-Mail-Registrierung.
Abhängigkeit: Kuratierung, Publikation und Portal liegen bei einem Anbieter. Das wirft Fragen nach Langzeitverfügbarkeit und nach der Anbindung an institutionelle Repositorien auf.
Was heißt das für Verlage?
Auch wenn es nicht um wissenschaftliche Publikationen geht, lohnt ein Blick auf den Vorgang.
Drei Lehren lassen sich mitnehmen.
Neue Produkte: Frontiers hat einen Inhaltstyp, der bisher als Beiwerk galt, zum Produkt mit eigenem Workflow, eigener Qualitätsschwelle und eigenem Preis gemacht. Wer auf strukturierten Inhalten sitzt, von Normteil-Tabellen über Rezeptdatenbanken bis zu Kursmaterialien, verfügt über ähnliche Nebenprodukte. Die Frage ist, welches davon mit Beglaubigung und Maschinenlesbarkeit ein eigenes Produkt hergibt.
Neue „Leser“: Croissant-Metadaten, offene Lizenz, persistente Identifikatoren, formale Spezifikation, Offenlegungspflicht für KI-Anteile. Nichts davon ist für Menschen gemacht. Wer Inhalte künftig an KI-Systeme lizenzieren will, muss sie so ausliefern, wie Frontiers seine Datensätze. Die Metadaten werden zum Produkt, der Inhalt hängt daran.
Neue Zuständigkeiten: Ho beobachtet das an ihrer eigenen Zunft. Weil die Daten nach der Publikation offen zugänglich sind, entfällt für Bibliotheken das Verwalten, und sie rücken in die Beratung bei Datenmanagementplänen, Publikationsbudgets und Langzeitarchivierung. Im Verlag läuft es umgekehrt. Je stärker eine KI das Sortieren und Beschreiben übernimmt, desto deutlicher muss der Verlag das Überwachen übernehmen. Er steht mit seinem Namen dafür ein, dass jemand die Daten geprüft hat.
Beglaubigen lässt sich nicht automatisieren
Ho empfiehlt, die Entwicklung zu beobachten und Verbreitung, Technik und Nachhaltigkeit im Auge zu behalten.
Für Institutionen mit komplexen Datensätzen, die Sichtbarkeit, Nachnutzung und Anerkennung suchen, könne die Plattform wertvoll sein.
Für Verlagsentscheidungen ist eine andere Erkenntnis wichtig. Frontiers hat die KI dort eingesetzt, wo sie am wenigsten Widerstand findet, beim Verpacken. Begutachten und Prüfen müssen aber weiterhin Menschen, und dort herrschen nach wie vor andere Geschwindigkeiten.
Wer seinen eigenen KI-Fahrplan schreibt, sollte sich diese Reihenfolge merken. Die Maschine beschleunigt das Aufbereiten. Das Überprüfen kann nicht so weit automatisiert werden, ist aber das Wichtigste, wofür man einen Verlag braucht.
Deutsche Bearbeitung der Rezension „A New Publishing Infrastructure Treats Datasets as Formal Research Outputs. Can It Work Across Disciplines?“ von Lilly Hoi Sze Ho, erschienen am 27. Mai 2026 im Katina Magazine (Annual Reviews), DOI 10.1146/katina-052726-1, CC BY-NC 4.0. Mit freundlicher Genehmigung der Autorin und des Katina Magazine.
Lilly Hoi Sze Ho (LinkedIn) ist eine erfahrene Fachfrau für Informationswissenschaft im Northern Territory, Australien. Sie verfügt über umfangreiche Erfahrung in Bibliothekstechnologien, Sammlungsmanagement, digitaler Infrastruktur, Metadatenstandards und technischen Diensten. Zu ihren fachlichen Interessen gehören digitale Sammlungen, Open Science, offene Infrastruktur, Bibliothekssysteme und die Entwicklung von Standards im Bibliotheks- und Informationswesen. International engagiert sie sich in der International Federation of Library Associations and Institutions (IFLA), unter anderem im Beirat für Open Science and Scholarship und in den Gremien der Regionaldivision Asien-Ozeanien. Außerdem wirkt sie an Standards- und Metadateninitiativen mit. Ho veröffentlicht Fachartikel und arbeitet als Buch- und Peer-Reviewerin. Ihre Arbeit zielt auf nachhaltige und interoperable Ansätze für Bibliothekstechnologien, digitalen Zugang und wissenschaftliche Informationsdienste.
Autorinnenfoto: privat.
Der Artikel ist Teil des Channels Digital Publishing Technologien, der sich mit Content-Strategien und Prozessen beschäftigt. Der Channel wird gesponsert von Fabasoft Xpublisher.