“Hey KI, welches Buch kannst du mir empfehlen?”
Studie zu Quellen von KI-Lesetipps
Diese Frage stellen immer mehr Menschen ChatGPT oder Gemini und bekommen prompt eine Handvoll Titel mit kurzer Begründung. Eine Studie der Münchner Digitalagentur Hattenberger Partner zeigt, woher die KI die Lesetipps nimmt, welche Verlage darin vorkommen und was Häuser tun können, um dazuzugehören.
Published: 29.9.2026 | Keyvisual: KI-generiert, Magnific
Wer 2026 ein Weihnachtsgeschenk sucht, vielleicht ein schönes Buch, fragt dafür mit steigender Wahrscheinlichkeit ChatGPT oder Gemini. Laut einer Studie von McKinsey nennen 44 Prozent der Nutzer und Nutzerinnen KI-Suche inzwischen als ihre bevorzugte Informationsquelle, die klassische Online-Suche kommt auf 31 Prozent. Aber was empfiehlt die KI dann und auf welche Quellen stützt sie sich? Die Digitalagentur Hattenberger Partner wollte es genau wissen und hat den beiden KI-Assistenten im August und September 228 Fragen nach Lesetipps gestellt, verteilt auf zwölf Segmente vom Krimi bis zum Finanzratgeber.
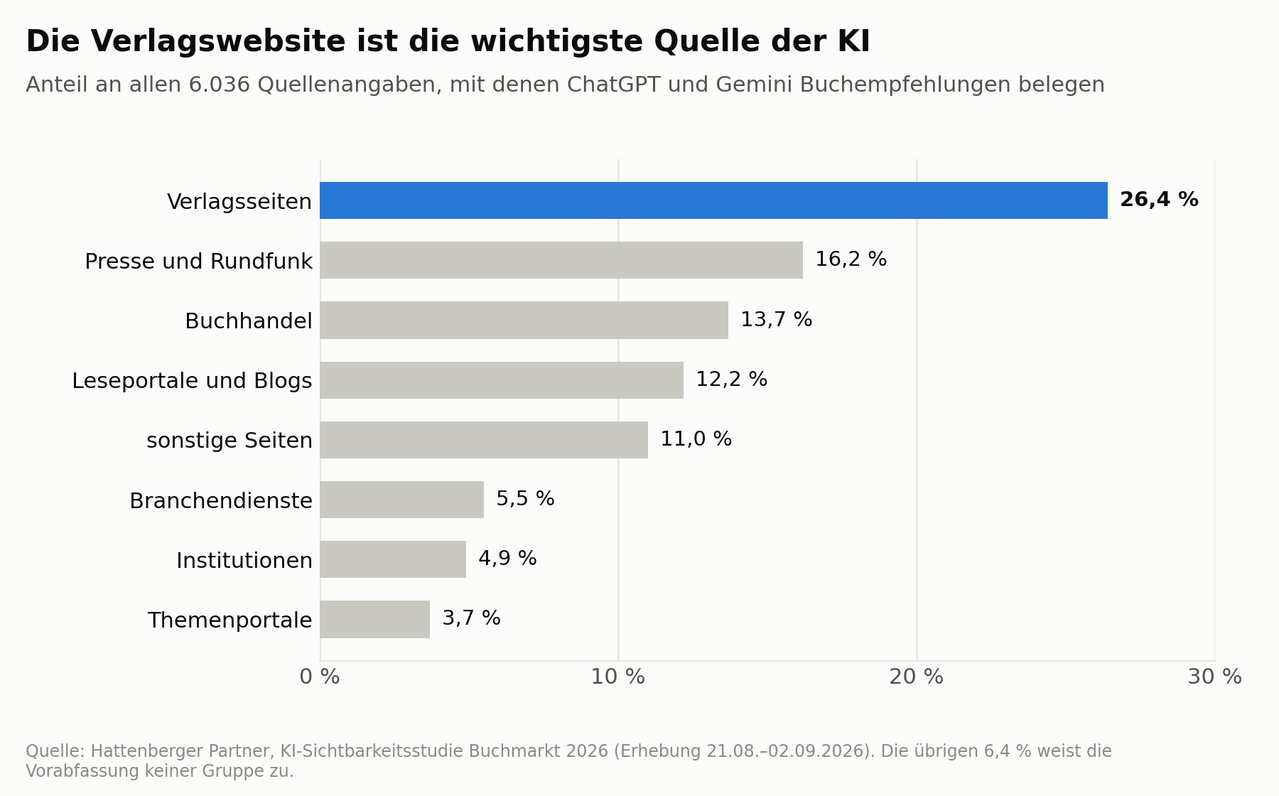
Die gute Nachricht: Die größte Quellengruppe stellen die Verlage selbst. Auf ihre Websites entfallen 1.591 Zitate, das sind 26,4 Prozent aller Belege. Presse und Rundfunk folgen mit 16,2 Prozent, der Buchhandel mit 13,7 Prozent, Leseportale und Blogs mit 12,2 Prozent.
Das ist insofern bemerkenswert, weil eine Verlagswebsite zum größten Teil Selbstdarstellung ist. Die KI behandelt sie trotzdem als eine unabhängige Quelle. Besonders deutlich wird das bei den Bestenlisten. 216 Zitate führen auf Ranglisten, die Verlage auf ihrer eigenen Seite veröffentlichen, etwa „die zehn besten Krimis“. Solche Listen enthalten ausschließlich Titel des eigenen Hauses. Die meistzitierte Ranglistenseite der Studie ist eine davon, sie liegt auf rowohlt.de und kommt auf 124 Zitate.
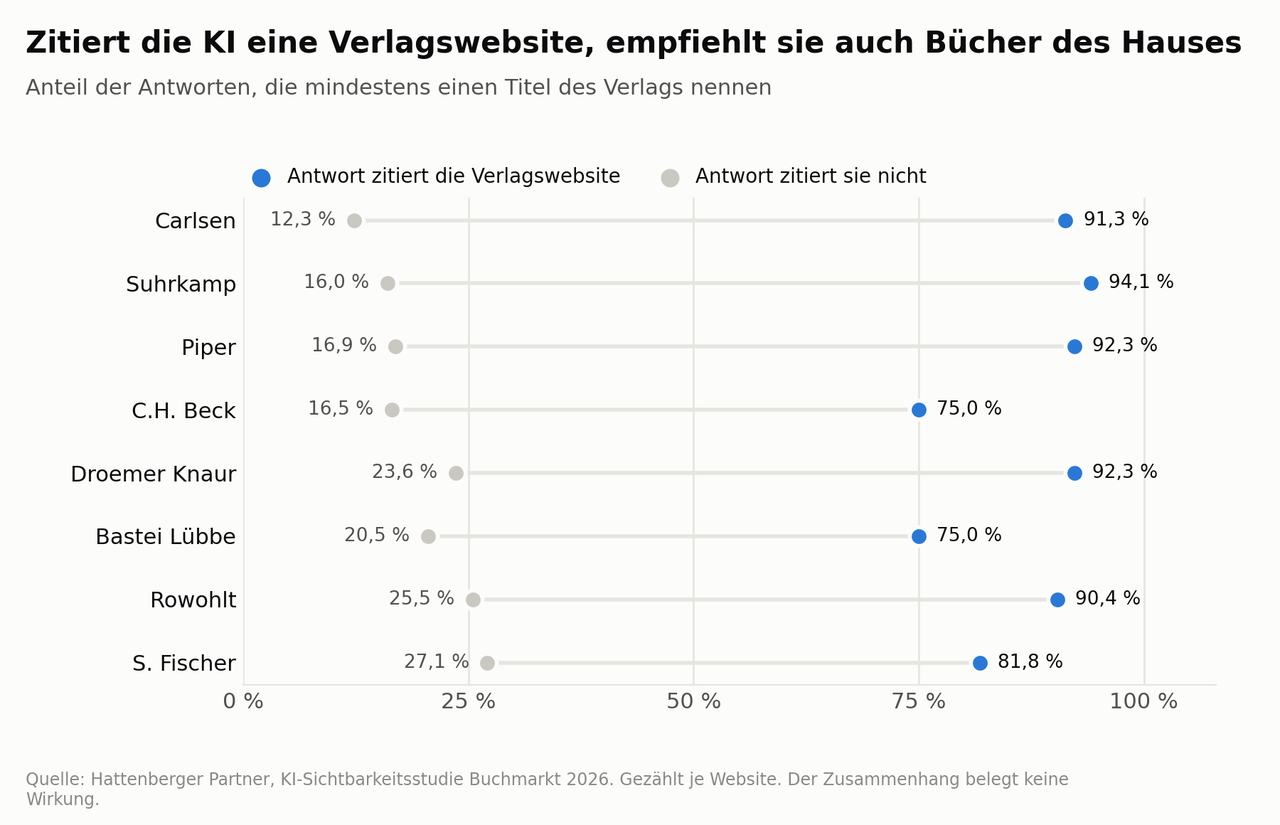
Für die Häuser zahlt sich das aus. Zitiert die KI die Website eines Verlags, stehen dessen Bücher fast immer mit darin. Bei Carlsen liegt dieser Wert bei 91,3 Prozent, in Antworten ohne Zitat der eigenen Seite bei 12,3 Prozent. Die Studie weist selbst darauf hin, dass sich Ursache und Wirkung hier nicht trennen lassen. Für die Praxis läuft es auf dasselbe hinaus: Wenn die KI eine Verlagsseite liest, empfiehlt sie auch die Bücher dieses Hauses.
Anzeige
ChatGPT liest das Feuilleton, Gemini die Verkaufscharts
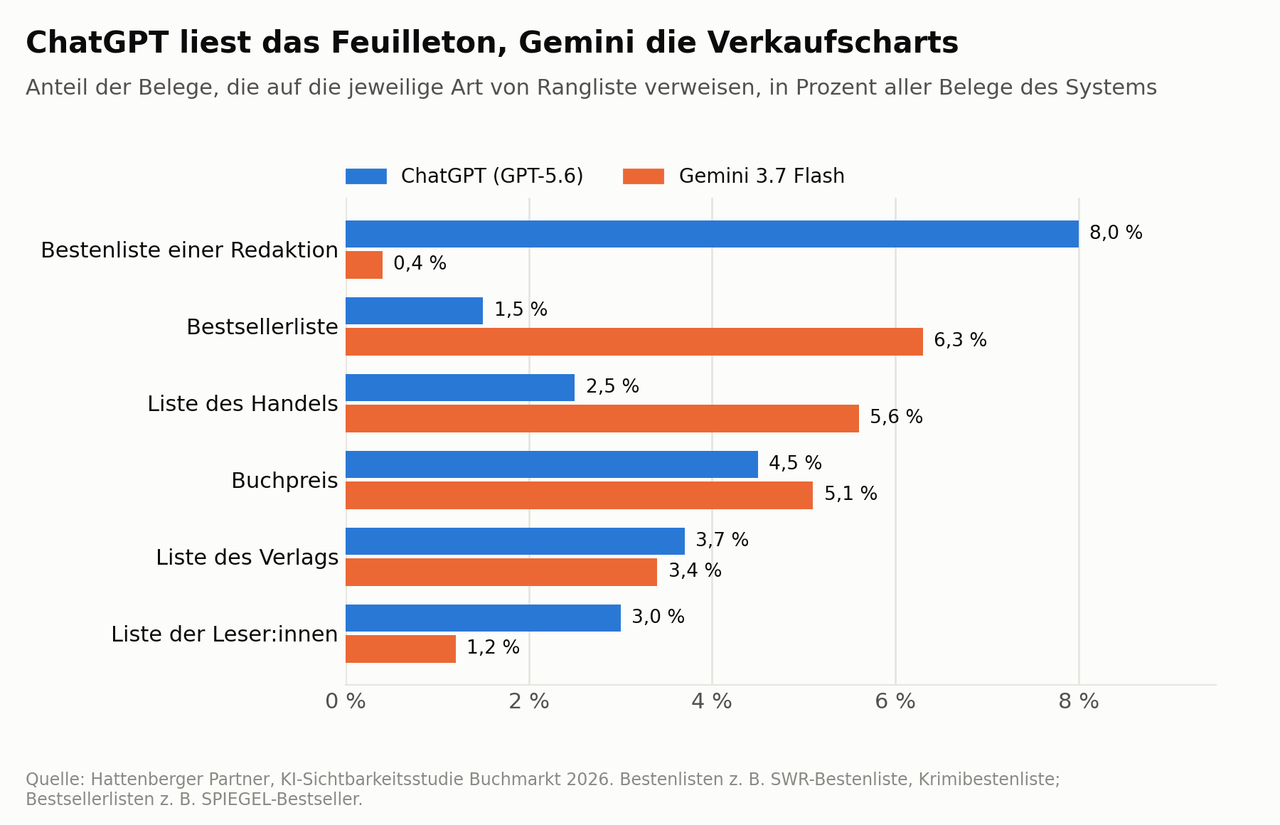
Dabei gehen ChatGPT und Gemini nicht gleich vor. Beide stützen sich etwa gleich häufig auf Ranglisten, bei ChatGPT führt jeder vierte Beleg auf eine solche Liste, bei Gemini fast jeder vierte. Allerdings sind es verschiedene Listen:
ChatGPT beruft sich auf Bestenlisten, die eine Redaktion zusammenstellt, etwa die SWR-Bestenliste, die Krimibestenliste oder die Buchtipps von Deutschlandfunk Kultur und NDR. Solche Listen tauchen beim Sprachmodell von OpenAI 277 Mal als Beleg auf, bei Googles Gemini dagegen nur ganze 10 Mal. Gemini stützt sich dafür auf Bestsellerlisten wie die des Spiegels und auf Ranglisten des Buchhandels. Insgesamt stammt bei Gemini fast jeder vierte Beleg aus dem Handel, bei ChatGPT nur jeder vierzehnte.
Für Verlage heißt das, dass es zwei Wege in die Antworten gibt. In eine Bestenliste kommt ein Titel über Rezensionen und Pressearbeit, in eine Bestsellerliste über Verkäufe und Präsenz im Handel. Allerdings schwanken die Empfehlungen stark: Die Studie hat jede Frage an drei Terminen gestellt, und nur 8,5 Prozent der genannten Titel tauchten in allen drei Antworten auf.
Größte Überraschung: Amazon fehlt als Quelle
Amazon ist der größte Buchhändler Deutschlands. In den 6.036 Quellenangaben, mit denen ChatGPT und Gemini ihre Buchempfehlungen belegen, kommt amazon.de kein einziges Mal vor.
Die Erklärung steht in der robots.txt, der Datei, mit der eine Website festlegt, welche Programme sie lesen dürfen. Amazon sperrt dort nach Angaben der Studie die Suchprogramme beider KI-Anbieter aus. Hugendubel sperrt keines davon und kommt auf 140 Zitate, Thalia auf 177. Die Konzerntochter Audible führt eine eigene Datei, lässt die Programme zu und wird 117 Mal zitiert.
Ein zweiter Fall zeigt, dass robots.txt mehr regelt, als man vielleicht annimmt. Die Bücher von Penguin Random House führen in der Zitierstatistik mehrere der angefragten Segmente an, Heyne etwa bei Fantasy und Science-Fiction. Die Verlagsmarken der Gruppe laufen unter der gemeinsamen Adresse penguin.de, aber diese Adresse kommt in keinem einzigen Zitat vor. Ein Blick in ihre robots.txt gibt zumindest eine Teilantwort: Dort ist der Eintrag Google-Extended gesperrt. Laut Googles Dokumentation regelt dieser Eintrag zwei Dinge zugleich. Er entscheidet, ob Inhalte in das Training künftiger Gemini-Modelle einfließen, und ob Gemini sie beim Beantworten einer Frage als Quelle heranziehen darf. Auf die normale Google-Suche hat er keinen Einfluss.
Wer seine Inhalte vom Training ausschließen will, verschwindet damit auch aus den Antworten von Gemini. Für ChatGPT erklärt die Datei den Befund übrigens nicht, dessen Suchprogramme dürfen penguin.de lesen. „Einen technischen Grund, warum ChatGPT die Seite trotzdem nicht zitiert, haben wir von außen nicht gefunden“, sagt Studienautor Dr. David Hanisch von Hattenberger Partner.
Was Verlage jetzt tun können
Die Studie leitet aus den Befunden drei Empfehlungen ab, sortiert nach Aufwand.
Eigene Bestenlisten führen. 216 Zitate der Studie stammen von Ranglisten, die Verlage auf ihrer eigenen Website veröffentlichen. Eine solche Seite braucht wenig. Eine klare Überschrift mit Genre und Jahreszahl, eine nummerierte Liste und zu jedem Titel zwei Sätze Einordnung mit Autor:in und Erscheinungsjahr im Fließtext. Reine Coverstrecken helfen wenig, die Systeme lesen Text.
Die eigene Website zur Quelle machen. Zitierfähig ist nach der Studie eine Seite, die eine Frage beantwortet, etwa für welches Lesealter ein Buch gedacht ist oder in welcher Reihenfolge die Bände einer Reihe gelesen werden. Autor:in, Jahr, Reihe und Band gehören in den sichtbaren Text und nicht nur in die Metadaten. Jede Verlagsmarke sollte eine eigene Adresse haben. Auch Verlagsvorschauen als öffentlich abgelegte PDFs tauchen in den Belegen auf.
Dort vorkommen, wo das eigene Genre zitiert wird. Welche Quellen die KI heranzieht, hängt stark vom Segment ab. Beim Sachbuch stammen 40,7 Prozent der Belege von Verlagsseiten, bei Romanen führen die Medien mit 31,9 Prozent, bei Fantasy die Leseportale und bei Finanzratgebern Themenportale außerhalb der Buchbranche. Wenn die KI Feuilletons zitiert, entscheidet die Pressearbeit, wenn sie Leseportale zitiert, die Community.
Die Studie wird zur Buchmesse in Frankfurt veröffentlicht unter https://hattenbergerpartner.de/
Zur Methode
KI-Sichtbarkeitsstudie Buchmarkt 2026 (Hattenberger Partner). 228 Fragen nach Buchempfehlungen in zwölf Segmenten, gestellt an ChatGPT (GPT-5.6) und Gemini 3.7 Flash mit Standort Deutschland, jeweils mit und ohne Websuche, an drei Terminen zwischen 21. August und 2. September 2026. 2.736 ausgewertete Antworten, 6.036 Quellenangaben aus 870 Adressen. Titel werden über den DNB-Katalog dem Verlag der deutschen Erstausgabe zugeordnet. Zitiert nach der Vorabfassung vom 21. September 2026.
Der Artikel ist Teil des Channels Digital Publishing Technologien, der sich mit Content-Strategien und Prozessen beschäftigt. Der Channel wird gesponsert von Fabasoft Xpublisher.